Реализация пузырьковой сортировки на java
Содержание:
- 2. Обзор алгоритмов сортировки
- 2.8 Теоретическое сравнение сортировок методом простых вставок и методом пузырька
- Как создать пузырьковую сортировку
- Сортировка пузырьком
- 2.4 Пирамидальная сортировка
- Анализ
- Как улучшить пузырьковую сортировку
- Модификации[править]
- 2.5 Сортировка Шелла
- Быстрая сортировка (Quick Sort)
- Заключение
2. Обзор алгоритмов сортировки
Сортировка — это процесс перестановки объектов данного множества в определённом порядке. Цель сортировки — облегчить последующий поиск элементов в отсортированном множестве. Поэтому элементы сортировки присутствуют во многих задачах прикладного программирования.
Рассмотрим алгоритмы сортировки «на месте», то есть те алгоритмы в которых не используется копирование массива.
Удобной мерой эффективности алгоритмов сортировки «на месте» является число необходимых сравнений в ходе сортировки и число необходимых пересылок элементов.
Эффективные алгоритмы сортировки требуют порядка
сравнений, где N — число элементов, а С — число необходимых сравнений.
Мы рассмотрим простые методы сортировки, которые требуют число сравнений порядка
Методы сортировки «на месте» можно разбить на три основных класса:
сортировка выбором
сортировка вставками
сортировка обменом
В сортировке выбором выбирается элемент с наибольшим значением ключа и меняется местами с последним. Затем то же самое повторяется для s-1 элемента. Найденный элемент с наибольшим значением ключа меняется
Рисунок 1. Сортировка простым выбором
В сортировке включениями элементы разделяются на уже упорядоченную и неупорядоченную последовательности. В начале упорядоченная часть содержит только один элемент. Очередной элемент из начала неупорядоченной части вставляется на подходящее место в упорядоченную часть. При этом упорядоченная часть удлиняется на один элемент, а неупорядоченная — укорачивается. Сортировка заканчивается при исчезновении неупорядоченной части (рисунок 2).
Рисунок 2. Сортировка простыми включениями
Основная характеристика сортировки обменом — перестановка местами двух соседних элементов, если они расположены не так, как требует отсортированный массив.
Рисунок 3. Сортировка простым обменом
В рассмотренной классификации существуют разные алгоритмы. Они отличаются сложностью, быстротой выполнения, последовательностью операций.
Например:
сортировка вставками;
пузырьковая сортировка;
корневая сортировка;
пирамидальная сортировка;
сортировка слиянием;
быстрая сортировка;
сортировка Шелла и др.
Рассмотрим подробнее основные типы и виды сортировок (сначала простые сортировки затем более сложные).
Сортировка массива простым выбором
Метод основан на следующем правиле:
Выбирается элемент с наибольшим значением ключа
Он меняется местами с последним элементом arr . Затем эти операции повторяются с оставшимися первыми s-1 элементами, затем — с s-2 первыми элементами и т.д. до тех пор, пока не останется только первый элемент — наименьший. Пример сортировки методом простого выбора показан на рисунке 4:
Рисунок 4. Сортировка массива простым выбором
Эффективность сортировки простым выбором. Число сравнений ключей не зависит от начального порядка ключей. Операция сравнения выполняется в теле цикла с управляющей переменной k
и средним числом повторений size/2. Этот цикл, в свою очередь, находится в теле цикла с управляющей переменной L
и числом повторений size −1. Таким образом, число сравнений
С= (size −1) * size −1/2
Число пересылок, напротив, зависит от начального порядка ключей. Если принять, что операция сравнения в теле цикла по k
дает результат «истина» в половине случаев, то среднее число пересылок в этом цикле равно size/4. Цикл по L
, как указывалось выше, выполняется size −1 раз и в теле цикла выполняется три пересылки и цикл по k
. С учетом этого число пересылок:
М= (3+ size/4) * (size −1)
Получаем, что при сортировке простым выбором и число сравнений, и число пересылок пропорционально .
2.8 Теоретическое сравнение сортировок методом простых вставок и методом пузырька
Выполним по рекомендованной литературе теоретическое сравнение алгоритмов сортировок, рассматриваемых в данном курсовом проекте. Основным критерием сравнения сортировок является их эффективность, то есть число сравнений и число пересылок. Данные показатели также влияют на время сортировки. Укажем основные формулы, использующиеся для вычисления эффективности данных сортировок:
− число сравнений ключей элементов при i-ом просеивании;
−минимальное число сравнений ключей;
− максимальное число сравнений ключей;
− среднее число сравнений ключей;
− число пересылок (присваиваний) элементов при i-ом просеивании;
− минимальное число пересылок
− максимальное число пересылок
− среднее число пересылок
− размер массива;
Рассмотрим сортировку методом простых вставок
Рассмотрим сортировку методом пузырька
На основе данных методических формул составим сравнительную таблицу для сортировок методом простых вставок и методом пузырька:
Таблица 2. Сравнительный анализ сортировок методом простых вставок и методом пузырька
|
Размер массива |
Метод простых вставок |
Метод пузырька |
||
|
Число сравнений ключей (среднее значение) |
Число пересылок (среднее значение) |
Число сравнений ключей (среднее значение) |
Число пересылок (среднее значение) |
|
|
32 |
263 |
329 |
256 |
384 |
|
64 |
1039 |
1163 |
1024 |
1536 |
|
128 |
4127 |
4379 |
4096 |
6144 |
|
256 |
16447 |
16953 |
16384 |
24576 |
|
512 |
65663 |
131835 |
65536 |
98304 |
|
1024 |
262399 |
264443 |
262144 |
393216 |
На основе полученных в таблице 2 значений составим сравнительные графики, для числа сравнений ключей и для числа пересылок по обоим методам сортировки:
Рисунок 10. Графики числа сравнений ключей: число сравнений ключей П — для метода пузырька, число сравнений ключей В — для метода простых вставок.
На основе полученных графиков можно сказать, что число сравнений ключей в сортировке методом пузырька число сравнений больше, чем в сортировке методом вставок. Следовательно по данному критерию эффективность сортировки методом простых вставок выше, чем методом пузырька.
Рисунок 11. Графики числа пересылок в сортировках: число пересылок П — для метода пузырька, число пересылок В — для метода простых вставок.
Основываясь на полученных графиках можно сказать, что при малых значениях размерности массива число пересылок для обоих методов примерно одинаково. При относительно больших размерах массива (от 512 и более) число пересылок в методе
пузырька возрастает быстрее, чем в методе простых вставок. Следовательно, эффективность метода вставок выше по данной характеристике.
Ссылаясь на таблицу 1 можно также отметить, что сортировка методом пузырька требует больше времени, чем сортировка методом вставок.
Из чего следует, что в целом сортировка методом простых вставок эффективнее сортировки методом пузырька.
Как создать пузырьковую сортировку
Вот что нам придется делать для создания пузырьковой сортировки:
- Создать два цикла , чтобы проходить по всем элементам массива раз ( это размер массива).
- Сравнивать ячейки массива, с помощью оператора ветвления .
- Менять местами значения ячеек.
В примере ниже мы предложили пользователю заполнить массив, который мы дальше отсортируем используя пузырьковую сортировку.
#include <iostream>
using namespace std;
int main() {
setlocale(LC_ALL, «rus»);
int digitals; // объявили массив на 10 ячеек
cout << «Введите 10 чисел для заполнения массива: » << endl;
for (int i = 0; i < 10; i++) {
cin >> digitals; // «читаем» элементы в массив
}
for (int i = 0; i < 10; i++) {
for (int j = 0; j < 9; j++) {
if (digitals > digitals) {
int b = digitals; // создали дополнительную переменную
digitals = digitals; // меняем местами
digitals = b; // значения элементов
}
}
}
cout << «Массив в отсортированном виде: «;
for (int i = 0; i < 10; i++) {
cout << digitals << » «; // выводим элементы массива
}
system(«pause»);
return 0;
}
|
1 |
#include <iostream> usingnamespacestd; intmain(){ setlocale(LC_ALL,»rus»); intdigitals10;// объявили массив на 10 ячеек cout<<«Введите 10 чисел для заполнения массива: «<<endl; for(inti=;i<10;i++){ cin>>digitalsi;// «читаем» элементы в массив } for(inti=;i<10;i++){ for(intj=;j<9;j++){ if(digitalsj>digitalsj+1){ intb=digitalsj;// создали дополнительную переменную digitalsj=digitalsj+1;// меняем местами digitalsj+1=b;// значения элементов } } } cout<<«Массив в отсортированном виде: «; for(inti=;i<10;i++){ cout<<digitalsi<<» «;// выводим элементы массива } system(«pause»); return; } |
Давайте поподробнее разберем строки 16 — 24 (здесь находится пузырьковая сортировка)
- В строке 16: мы создали первый цикл .
- В строке 17: аналогично был создан второй, но уже вложенный цикл.
-
В строке 18: происходит сравнивание двух элементов.
- Если результат этого условия положительный, то мы меняем значение элементов.
- Если же результат отрицателен, то мы пропускаем этап смены значений.
- В строке 19: создали переменную , чтобы менять значения ячеек и местами.
Давайте посмотрим, что выведет программа выше при запуске:
sort_puzerek.cpp
Введите 10 чисел для заполнения массива:
5 3 6 2 7 0 2 8 9 10
Массив в отсортированном виде: 0 2 2 3 5 6 7 8 9 10
Process returned 0 (0x0) execution time : 0.005 s
Press any key to continue.
Сортировка пузырьком
Идея алгоритма очень простая. Идём по массиву чисел и проверяем порядок (следующее число должно быть больше и равно предыдущему), как только наткнулись на нарушение порядка, тут же обмениваем местами элементы, доходим до конца массива, после чего начинаем сначала.
Отсортируем массив {1, 5, 2, 7, 6, 3}
Идём по массиву, проверяем первое число и второе, они идут в порядке возрастания. Далее идёт нарушение порядка, меняем местами эти элементы
Продолжаем идти по массиву, 7 больше 5, а вот 6 меньше, так что обмениваем из местами
3 нарушает порядок, меняем местами с 7
Возвращаемся к началу массива и проделываем то же самое
void bubbleSort(int *a, size_t size) {
	size_t i, j;
	int tmp;
	for (i = 1; i < size; i++) {
		for (j = 1; j < size; j++) {
			if (a > a) {
				tmp = a;
				a = a;
				a = tmp;
			}
		}
	}
}
Этот алгоритм всегда будет делать (n-1)2 шагов, независимо от входных данных. Даже если массив отсортирован, всё равно он будет пройден (n-1)2 раз. Более того, будут в очередной раз проверены уже отсортированные данные.
Пусть нужно отсортировать массив 1, 2, 4, 3
После того, как были поменяны местами элемента a и a нет больше необходимости проходить этот участок массива
Примем это во внимание и переделаем алгоритм
void bubbleSort2(int *a, size_t size) {
	size_t i, j;
	int tmp;
	for (i = 1; i < size; i++) {
		for (j = i; j > 0; j--) {
			if (a < a) {
				tmp = a;
				a = a;
				a = tmp;
			}
		}
	}
}
Ещё одна реализация
void bubbleSort2b(int *a, size_t size) {
	size_t i, j;
	int tmp;
	for (i = 1; i < size; i++) {
		for (j = 1; j <= size-i; j++) {
			if (a < a) {
				tmp = a;
				a = a;
				a = tmp;
			}
		}
	}
}
В данном случае будет уже вполовину меньше шагов, но всё равно остаётся проблема сортировки уже отсортированного массива: нужно сделать так, чтобы отсортированный массив функция просматривала один раз. Для этого введём переменную-флаг: он будет опущен (flag = 0), если массив отсортирован. Как только мы наткнёмся на нарушение порядка, то флаг будет поднят (flag = 1) и мы начнём сортировать массив как обычно.
void bubbleSort3(int *a, size_t size) {
	size_t i;
	int tmp;
	char flag;
	do {
		flag = 0;
		for (i = 1; i < size; i++) {
			if (a < a) {
				tmp = a;
				a = a;
				a = tmp;
				flag = 1;
			}
		}
	} while (flag);
}
В этом случае сложность также порядка n2, но в случае отсортированного массива будет всего один проход.
Теперь усовершенствуем алгоритм. Напишем функцию общего вида, чтобы она сортировала массив типа void. Так как тип переменной не известен, то нужно будет дополнительно передавать размер одного элемента массива и функцию сравнения.
int intSort(const void *a, const void *b) {
	return *((int*)a) > *((int*)b);
}

void bubbleSort3g(void *a, size_t item, size_t size, int (*cmp)(const void*, const void*)) {
	size_t i;
	void *tmp = NULL;
	char flag;

	tmp = malloc(item);

	do {
		flag = 0;
		for (i = 1; i < size; i++) {
			if (cmp(((char*)a + i*item), ((char*)a + (i-1)*item))) {
				memcpy(tmp, ((char*)a + i*item), item);
				memcpy(((char*)a + i*item), ((char*)a + (i-1)*item), item);
				memcpy(((char*)a + (i-1)*item), tmp, item);
				flag = 1;
			}
		}
	} while (flag);

	free(tmp);
}
Функция выглядит некрасиво – часто вычисляется адрес текущего и предыдущего элемента. Выделим отдельные переменные для этого.
void bubbleSort3gi(void *a, size_t item, size_t size, int (*cmp)(const void*, const void*)) {
	size_t i;
	void *tmp = NULL;
	void *prev, *cur;
	char flag;

	tmp = malloc(item);

	do {
		flag = 0;
		i = 1;
		prev = (char*)a;
		cur  = (char*)prev + item;
		while (i < size) {
			if (cmp(cur, prev)) {
				memcpy(tmp, prev, item);
				memcpy(prev, cur, item);
				memcpy(cur, tmp, item);
				flag = 1;
			}
			i++;
			prev = (char*)prev + item;
			cur  = (char*)cur  + item;
		}
	} while (flag);

	free(tmp);
}
Теперь с помощью этих функций можно сортировать массивы любого типа, например
void main() {
	int a = {1, 0, 9, 8, 7, 6, 2, 3, 4, 5};
	int i;

	bubbleSort3gi(a, sizeof(int), 10, intSort);
	for (i = 0; i < 10; i++) {
		printf("%d ", a);
	}
	_getch();
}
2.4 Пирамидальная сортировка
Пирамида определяется как последовательность ключей
hl, hl+1,…, hr, такая, что hi <= h2i, hi <= h2i+1
для всякого i =l,…,r/2. Если двоичное дерево представлено в виде массива, как показано на рис.1, то, следовательно, деревья сортировки на рис.2 и 3 являются пирамидами, и, в частности, элемент h1 пирамиды является ее наименьшим элементом h1 = min (h1… hn).
Теперь предположим, что дана пирамида с элементами hl+1,…, hr для некоторых значений l и r и нужно добавить новый элемент x для того, чтобы сформировать расширенную пирамиду hl,…, hr. Возьмем, например, исходную пирамиду h1,…,h7, показанную на рис.2, и расширим эту пирамиду «влево», добавив элемент h1=44. Новый элемент x сначала помещается в вершину дерева, а затем «просеивается» по пути, на котором находятся меньшие по сравнению с ним элементы, которые одновременно поднимаются вверх; таким образом формируется новая пирамида. На рисунке 8 продемонстрирована пирамидальная сортировка.
Рисунок 8. Процесс построения дерева
В данном примере значение 44 сначала меняется местами с 06, затем 12, и так формируется дерево. Далее процесс просеивания будем формулировать следующим образом: i, j — пара индексов, обозначающих элементы, которые нужно менять местами на каждом шаге просеивания.
Для восьми элементов из нашего примера минимальное и максимальное количества пересылок дают следующие исходные последовательности:
Мmin = 13 для последовательности
94, 67, 44, 55, 12, 42, 18, 6
Mmax=24 для последовательности
18, 42, 12, 44, 6, 55, 67, 94
Среднее число пересылок равно приблизительно nlog (n) /2 и отклонения от этого значения сравнительно малы.
Анализ
Пример пузырьковой сортировки. Начиная с начала списка, сравните каждую соседнюю пару, поменяйте их местами, если они не в правильном порядке (последняя меньше первой). После каждой итерации нужно сравнивать на один элемент меньше (последний), пока не останется больше элементов для сравнения.
Производительность
Пузырьковая сортировка имеет наихудший случай и среднюю сложность О ( n 2 ), где n — количество сортируемых элементов. Большинство практических алгоритмов сортировки имеют существенно лучшую сложность в худшем случае или в среднем, часто O ( n log n ). Даже другое О ( п 2 ) алгоритмы сортировки, такие как вставки рода , как правило , не работать быстрее , чем пузырьковой сортировки, а не более сложным. Следовательно, пузырьковая сортировка не является практическим алгоритмом сортировки.
Единственное существенное преимущество пузырьковой сортировки перед большинством других алгоритмов, даже быстрой сортировкой , но не сортировкой вставкой , заключается в том, что в алгоритм встроена способность определять, что список сортируется эффективно. Когда список уже отсортирован (в лучшем случае), сложность пузырьковой сортировки составляет всего O ( n ). Напротив, большинство других алгоритмов, даже с лучшей средней сложностью , выполняют весь свой процесс сортировки на множестве и, следовательно, являются более сложными. Однако сортировка вставкой не только разделяет это преимущество, но также лучше работает со списком, который существенно отсортирован (с небольшим количеством инверсий ).
В случае больших коллекций следует избегать пузырьковой сортировки. Это не будет эффективно в случае коллекции с обратным порядком.
Кролики и черепахи
Расстояние и направление, в котором элементы должны перемещаться во время сортировки, определяют производительность пузырьковой сортировки, поскольку элементы перемещаются в разных направлениях с разной скоростью. Элемент, который должен переместиться в конец списка, может перемещаться быстро, потому что он может принимать участие в последовательных заменах. Например, самый большой элемент в списке будет выигрывать при каждом обмене, поэтому он перемещается в свою отсортированную позицию на первом проходе, даже если он начинается с начала. С другой стороны, элемент, который должен двигаться к началу списка, не может перемещаться быстрее, чем один шаг за проход, поэтому элементы перемещаются к началу очень медленно. Если наименьший элемент находится в конце списка, потребуется n -1 проход, чтобы переместить его в начало. Это привело к тому, что эти типы элементов были названы кроликами и черепахами соответственно в честь персонажей басни Эзопа о Черепахе и Зайце .
Были предприняты различные усилия по устранению черепах, чтобы повысить скорость сортировки пузырей. Сортировка коктейлей — это двунаправленная сортировка пузырьков, которая идет от начала до конца, а затем меняет свое направление, идя от конца к началу. Он может довольно хорошо перемещать черепах, но сохраняет сложность наихудшего случая O (n 2 ) . Комбинированная сортировка сравнивает элементы, разделенные большими промежутками, и может очень быстро перемещать черепах, прежде чем переходить к все меньшим и меньшим промежуткам для сглаживания списка. Его средняя скорость сопоставима с более быстрыми алгоритмами вроде быстрой сортировки .
Пошаговый пример
Возьмите массив чисел «5 1 4 2 8» и отсортируйте его от наименьшего числа к наибольшему с помощью пузырьковой сортировки. На каждом этапе сравниваются элементы, выделенные жирным шрифтом . Потребуется три прохода;
- Первый проход
- ( 5 1 4 2 8) → ( 1 5 4 2 8). Здесь алгоритм сравнивает первые два элемента и меняет местами, поскольку 5> 1.
- (1 5 4 2 8) → (1 4 5 2 8), поменять местами, поскольку 5> 4
- (1 4 5 2 8) → (1 4 2 5 8), поменять местами, поскольку 5> 2
- (1 4 2 5 8 ) → (1 4 2 5 8 ). Теперь, поскольку эти элементы уже в порядке (8> 5), алгоритм не меняет их местами.
- Второй проход
- ( 1 4 2 5 8) → ( 1 4 2 5 8)
- (1 4 2 5 8) → (1 2 4 5 8), поменять местами, поскольку 4> 2
- (1 2 4 5 8) → (1 2 4 5 8)
- (1 2 4 5 8 ) → (1 2 4 5 8 )
Теперь массив уже отсортирован, но алгоритм не знает, завершился ли он. Алгоритм нужен один весь проход без какой — либо свопа знать сортируется.
- Третий проход
- ( 1 2 4 5 8) → ( 1 2 4 5 8)
- (1 2 4 5 8) → (1 2 4 5 8)
- (1 2 4 5 8) → (1 2 4 5 8)
- (1 2 4 5 8 ) → (1 2 4 5 8 )
Как улучшить пузырьковую сортировку
Ниже вы можете видеть оптимизированную версию пузырьковой сортировки.
for (int i = 0; i < 10; i++) {
bool flag = true;
for (int j = 0; j < 10 — (i + 1); j++) {
if (digitals > digitals) {
flag = false;
swap (digitals, digitals);
}
}
if (flag) {
break;
}
}
|
1 |
for(inti=;i<10;i++){ boolflag=true; for(intj=;j<10-(i+1);j++){ if(digitalsj>digitalsj+1){ flag=false; swap(digitalsj,digitalsj+1); } } if(flag){ break; } } |
Давайте посмотрим, что мы сделали для ее оптимизации:
- В строке 17: изменили условие внутреннего цикла на .Поэтому чтобы лишний раз не сравнивать элементы массива тратя на это время, мы решили уменьшать отрезок внутреннего цикла на 1, после каждого полного прохода внешнего цикла.
- Вы могли заметить, что если даже массив стал отсортирован (или сразу был отсортирован) алгоритм все равно продолжает сравнивать элементы.
Для этого в строке 5: чтобы пузырьковая сортировка останавливалась (когда массив уже стал отсортирован), мы объявили булеву переменную (ее обычно называют флаг или флажок). Еще при ее инициализации мы поместили значение , но она меняется на:
false, если результат условия в строке 4: положительный.
А в строке 9: чтобы мы могли выйти из алгоритма мы проверяем:
- Если булева переменная равна , значит массив уже полностью отсортирован и можно выйти. Для этого используем оператор .
- Если же значение равно , то продолжаем сортировать массив.
В строке 6: вы (возможно) увидели незнакомую функцию . Если коротко описать что она делает, то она принимает два аргумента (через запятую) и меняет их значения местами. В нашем случаи она принимает ячейки и . Мы использовали эту функцию чтобы не писать вот эти 3 строчки:
int b = digitals;
digitals = digitals;
digitals = b;
|
1 |
intb=digitalsj; digitalsj=digitalsj+1; digitalsj+1=b; |
Использовать ее необязательно, потому что она не сделает код быстрее. Но как мы сказали выше, кода станет меньше.
Модификации[править]
Сортировка чет-нечетправить
Сортировка чет-нечет (англ. odd-even sort) — модификация пузырьковой сортировки, основанная на сравнении элементов стоящих на четных и нечетных позициях независимо друг от друга. Сложность — .
Псевдокод указан ниже:
function oddEvenSort(a):
  for i = 0 to n - 1
    if i mod 2 == 0
      for j = 2 to n - 1 step 2
        if a < a
          swap(a, a)
    else
      for j = 1 to n - 1 step 2
        if a < a
          swap(a, a)
Преимущество этой сортировки — на нескольких процессорах она выполняется быстрее, так как четные и нечетные индексы сортируются параллельно.
Сортировка расческойправить
Сортировка расческой (англ. comb sort) — модификация пузырьковой сортировки, основанной на сравнении элементов на расстоянии. Сложность — , но стремится к . Является самой быстрой квадратичной сортировкой. Недостаток — она неустойчива. Псевдокод указан ниже:
function combSort(a):
  k = 1.3
  jump = n
  bool swapped = true
  while jump > 1 and swapped
    if jump > 1
      jump /= k
    swapped = false
    for i = 0 to size - jump - 1
      if a < a
        swap(a, a)
        swapped = true
Пояснения: Изначально расстояние между сравниваемыми элементами равно , где — оптимальное число для этого алгоритма. Сортируем массив по этому расстоянию, потом уменьшаем его по этому же правилу. Когда расстояние между сравниваемыми элементами достигает единицы, массив досортировывается обычным пузырьком.
Сортировка перемешиваниемправить
Сортировка перемешиванием (англ. cocktail sort), также известная как Шейкерная сортировка — разновидность пузырьковой сортировки, сортирующая массив в двух направлениях на каждой итерации. В среднем, сортировка перемешиванием работает в два раза быстрее пузырька. Сложность — , но стремится она к , где — максимальное расстояние элемента в неотсортированном массиве от его позиции в отсортированном массиве. Псевдокод указан ниже:
function shakerSort(a):
  begin = -1
  end = n - 2
  while swapped
    swapped = false
    begin++
    for i = begin to end
      if a > a
        swap(a, a)
        swapped = true
    if !swapped
      break
    swapped = false
    end--
    for i = end downto begin
      if a > a
        swap(a, a)
        swapped = true
2.5 Сортировка Шелла
На рисунке 9 продемонстрирована сортировка методом Шелла:
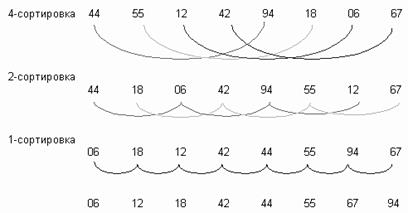
Рисунок 9. Сортировка Шелла
На первом проходе отдельно группируются и сортируются все элементы, отстоящие друг от друга на четыре позиции. Этот процесс называется 4-сортировкой. В нашем примере из восьми элементов каждая группа содержит ровно два элемента. После этого элементы вновь объединяются в группы с элементами, отстоящими друг от друга на две позиции, и сортируются заново. Этот процесс называется 2-сортировкой. Наконец на третьем проходе все элементы сортируются обычной 1-сортировкой включением.
На каждом шаге в сортировке участвует либо сравнительно мало элементов, либо они уже довольно хорошо упорядочены и требуют относительно мало перестановок. Очевидно, что этот метод дает упорядоченный массив, и также совершенно ясно, что каждый проход будет использовать результаты предыдущего прохода, поскольку каждая i-сортировка объединяет две группы, рассортированные предыдущей 2i-сортировкой. Также ясно, что приемлема любая последовательность приращений, лишь бы последнее было равно 1, так как в худшем случае вся работа будет выполняться на последнем проходе. Однако менее очевидно, что метод убывающего приращения дает даже лучшие результаты, когда приращения не являются степенями двойки. Таким образом, программа разрабатывается вне связи с конкретной последовательностью приращений. Все t приращений обозначаются через
h1, h2,…, hn с условиями ht=1, hi+1 < hi.
Каждая h-сортировка программируется как сортировка простыми включениями, при этом, для того чтобы условие окончания поиска места включения было простым, используется барьер. Ясно, что каждая h-сортировка требует собственного барьера и что программа должна определять его место как можно проще.
Быстрая сортировка (Quick Sort)
Этот широко известный алгоритм сортировки был разработан английским информатиком Чарльзом Хоаром во время его работы в МГУ в советские годы.
Один из самых быстрых известных универсальных алгоритмов сортировки массивов: в среднем O(n log n) обменов при упорядочении n-элементов; из-за наличия ряда недостатков на практике обычно используется с некоторыми доработками.
Быстрая сортировка относится к алгоритмам «разделяй и властвуй».
Алгоритм состоит из трёх шагов:
- Выбор опорного элемента из массива.
- Перераспределение элементов в массиве таким образом, что элементы меньше опорного помещаются перед ним, а больше или равные — после.
- Рекурсивное применение первых двух шагов к двум подмассивам слева и справа от опорного элемента. Рекурсия не применяется к массиву, в котором только один или отсутствуют элементы.
С исходным кодом алгоритма и его интерактивной презентацией вы сможете ознакомиться на специальном ресурсе.
Заключение
Метод пузырька гораздо менее эффективен других алгоритмов, однако он имеет простую и понятную реализацию, поэтому часто используется в учебных целях. Кроме того, пузырьковая сортировка может использоваться для работы с небольшими массивами данных.
На самом деле, вместо самостоятельного написания алгоритмов сортировки программисты на Python используют стандартные функции и методы языка, такие как и . Эти функции отлажены и работают быстро и эффективно.
Знания особенностей алгоритмов сортировки, их сложности и принципов реализации в общем виде пригодятся каждому программисту, желающему пройти собеседование и стать Python-разработчиком.







