Encoding.utf8 свойство
Содержание:
- Переход к Unicode
- Неправильная кодировка HTML страниц
- Набор номера
- Как задать кодировку UTF-8
- 10000000 – 11111111
- Инструменты для работы с кодировками HTML файлов
- Где указать кодировку сайта
- 4 интерфейса в encoding
- Как определить кодировку на сайте
- Библиотека преобразований Unicode-кодировок
- ASCII
- UTF-8
- Кодировки на основе Unicode
- Если кодировка не отображается
- Утилита Over Drive
- [править] BOM (сигнатура)
Переход к Unicode
Развитие интернета, увеличение количества компьютеров и удешевление памяти привели к тому, что проблемы, которые доставляла путаница в кодировках, стали перевешивать некоторую экономию памяти. Особенно ярко это проявлялось в интернете, когда текст написанный на одном компьютере должен был корректно отображаться на многих других устройствах. Это доставляло огромные проблемы как программистам, которые должны были решать какую кодировку использовать, так и конечным пользователям, которые не могли получить доступ к интересующим их текстам.
В результате в октябре 1991 года появилась первая версия одной общей таблицы символов, названной Unicode. Она включала в себя на тот момент 7161 различный символ из 24 письменностей мира.
В Unicode постепенно добавлялись новые языки и символы. Например, в версию 1.0.1 в середине 1992 года добавили более 20 000 идеограмм китайского, японского и корейского языков. В актуальной на текущий момент версии содержится уже более 143 000 символов.
Неправильная кодировка HTML страниц
Создадим тестовый файлик:
sudo gedit /var/www/html/encoding.html
Скопируем в него следующий HTML код, в котором отсутствует указание кодировки и посмотрим, какие проблемы могут с ним возникнуть и как их решить:
<html>
  <head>
    <title>Проверка кодировки</title>
   </head>
  <body>
    <h1>Тестовый файл для проверки кодировки</h1>
  </body>
</html>
Откроем этот файл в браузере http://localhost/encoding.html
Как можно видеть, кодировка браузером определена неправильно:
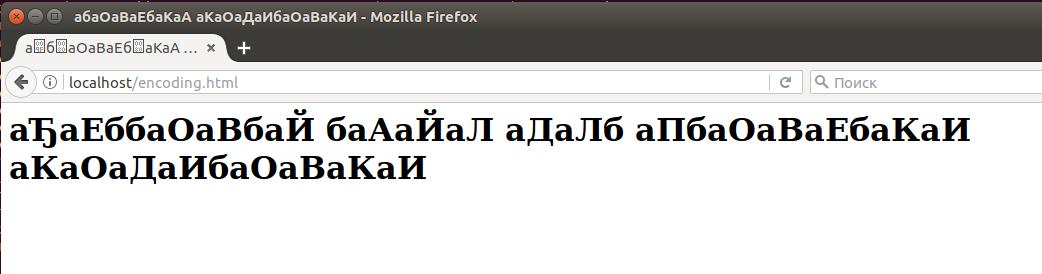
Имеется несколько способов исправить эту ситуацию. Начнём с самого простого – явно указать кодировку для веб-страницы. Это делается метатегом, который должен быть расположен внутри тэга head:
<meta http-equiv="content-type" content="text/html; charset=utf-8" />
Добавим эту строку к нашему тестовому файлику, чтобы получилось так:
<html>
  <head>
    <title>Проверка кодировки</title>
    <meta http-equiv="content-type" content="text/html; charset=utf-8" />
   </head>
  <body>
    <h1>Тестовый файл для проверки кодировки</h1>
  </body>
</html>
Как мы можем убедиться на следующем скриншоте, проблема решена:

Если кодировка вашего файла отличается от UTF-8, то вместо неё поставьте windows-1251 или ту, которая соответствует кодировке веб-страницы. Чтобы научиться определять кодировку файлов, посмотрите эту инструкцию.
Это был самый простой способ исправления проблемы с кодировкой – без изменения настроек сервера.
Вернём наш тестовый файл в исходное состояние и продолжим изучение способов указания кодировки.
Если файлы .htaccess включены настройками Apache, то эти файлы можно использовать чтобы указывать кодировку отправляемых веб-сервером страниц. Чтобы включить поддержку файлов .htaccess в конфигурационном файле Apache ( /etc/apache2/apache2.conf ) найдите группу строк
<Directory /var/www/>
	Options Indexes FollowSymLinks
	AllowOverride None
	Require all granted
</Directory>
И в ней замените
AllowOverride None
на
AllowOverride All
После этого сервер нужно перезапустить.
sudo systemctl restart apache2.service
Файл .htaccess должен быть размещён в той же директории, что и сайт. Мой сайт размещён в корневой директории веб-сервера. Если у вас также, то теперь в папке /var/www/html/ создайте файл .htaccess и добавьте в него директиву AddDefaultCharset после которой укажите желаемую кодировку. Примеры
AddDefaultCharset UTF-8
ИЛИ
AddDefaultCharset windows-1251
Можно указать кодировку, которая будет применена только к файлам определённого формата:
AddCharset utf-8 .atom .css .js .json .rss .vtt .xml
Набор файлов может быть любым, например:
AddCharset utf-8 .html .css .php .txt .js
Следующий вариант является альтернативным и также позволяет устанавливать кодировку для файлов определённого типа, для него нужно, чтобы был включён mod_headers:
<Files ~ "\.html?$">
     Header set Content-Type "text/html; charset=utf-8"
</Files>
Ещё один вариант, который также можно использовать в файле .htaccess для установки кодировки UTF-8:
IndexOptions +Charset=utf-8
Если сайт на PHP, то дополнительно может понадобиться продублировать кодировку с php_value default_charset:
AddDefaultCharset windows-1251
php_value default_charset "cp1251"
Можно вместо создания файла .htaccess установить кодировку в конфигурационном файле веб-сервера. Для Apache CentOS/Fedora это файл httpd.conf, а на Debian/Ubuntu это файл apache2.conf. Добавьте следующую строку для установки кодировки и перезапустите веб-сервер, чтобы изменения вступили в силу:
AddDefaultCharset UTF-8
Набор номера
Как задать кодировку UTF-8
В HTML кодировка UTF-8 устанавливается с помощью следующего кода:
˂head˃
˂meta http-equiv=»Content-Type» content=»text/html; charset=utf-8″˃
В PHP кодировка UTF-8 задаётся с помощью функции header() в самом начале файла после задания значения уровня вывода ошибок:
˂?php
error_reporting(-1);
header(‘Content-Type: text/html; charset=utf-8’);
Для подключения к базам данных MySQL кодировка UTF-8 устанавливается так:
˂?php
mysql_set_charset(‘utf8’);
В CSS-файлах кодировка символов UTF-8 указывается так:
@charset «utf-8»;
При сохранении файлов всех типов выбирается кодировка UTF-8 без BOM, иначе сайт работать не будет. Для этого в программе DreamWeave нужно выбрать пункт меню «Модификации – Свойства страницы – Заголовок/Кодировка», изменить кодировку на UTF-8. Затем следует перезагрузить страницу, убрать галочку из пункта «Подключить Юникод сигнатуры (BOM)» и применить изменения. Если какой-либо текст на странице или в базе данных был введён другой формой кодирования, то его нужно ввести заново или перекодировать. При работе с регулярными выражениями обязательно использовать модификатор u.
Также можно сохранить файл в кодировке UTF-8 в «Блокноте» ОС Windows. После выбора пункта меню «Файл – Сохранить как…» установить необходимую форму кодирования и сохранить файл в кодировке UTF-8.
В текстовом редакторе Notepad++, если кодировка отлична от UTF-8, через пункт меню «Преобразовать в UTF-8 без BOM» изменить кодировку и сохранить в кодировке UTF-8.
10000000 – 11111111
Альтернативная часть таблицы (русская). Вторая половина кодовой таблицы ASCII, называемая кодовой страницей (128 кодов, начиная с 10000000 и кончая 11111111), может иметь различные варианты, каждый вариант имеет свой номер. Кодовая страница в первую очередь используется для размещения национальных алфавитов, отличных от латинского. В русских национальных кодировках в этой части таблицы размещаются символы русского алфавита.
Первая половина таблицы кодов ASCII
Обращаю ваше внимание на то, что в таблице кодировки буквы (прописные и строчные) располагаются в алфавитном порядке, а цифры упорядочены по возрастанию значений. Такое соблюдение лексикографического порядка в расположении символов называется принципом последовательного кодирования алфавита
Для букв русского алфавита также соблюдается принцип последовательного кодирования.
Вторая половина таблицы кодов ASCII
К сожалению, в настоящее время существуют пять различных кодировок кириллицы (КОИ8-Р, Windows. MS-DOS, Macintosh и ISO). Из-за этого часто возникают проблемы с переносом русского текста с одного компьютера на другой, из одной программной системы в другую.
Хронологически одним из первых стандартов кодирования русских букв на компьютерах был КОИ8 («Код обмена информацией, 8-битный»). Эта кодировка применялась еще в 70-ые годы на компьютерах серии ЕС ЭВМ, а с середины 80-х стала использоваться в первых русифицированных версиях операционной системы UNIX.
От начала 90-х годов, времени господства операционной системы MS DOS, остается кодировка CP866 («CP» означает «Code Page», «кодовая страница»).
Компьютеры фирмы Apple, работающие под управлением операционной системы Mac OS, используют свою собственную кодировку Mac.
Кроме того, Международная организация по стандартизации (International Standards Organization, ISO) утвердила в качестве стандарта для русского языка еще одну кодировку под названием ISO 8859-5.
Наиболее распространенной в настоящее время является кодировка Microsoft Windows, обозначаемая сокращением CP1251.
С конца 90-х годов проблема стандартизации символьного кодирования решается введением нового международного стандарта, который называется Unicode. Это 16-разрядная кодировка, т.е. в ней на каждый символ отводится 2 байта памяти. Конечно, при этом объем занимаемой памяти увеличивается в 2 раза. Но зато такая кодовая таблица допускает включение до 65536 символов. Полная спецификация стандарта Unicode включает в себя все существующие, вымершие и искусственно созданные алфавиты мира, а также множество математических, музыкальных, химических и прочих символов.
Преобразуйте двоичный текст в текстовый / английский или ASCII, используя prepostseoБинарный переводчик. Введите двоичные числа (например, 01000101 01111000 01100001 01101101 01110000 01101100 01100101) и нажмите кнопку Преобразовать
Инструменты для работы с кодировками HTML файлов
Собственно, их всего три:
- PSPad. Бесплатный текстовый редактор, мой любимый.
- Notepad++. Еще один хороший текстовый редактор и тоже бесплатный.
- Dreamweaver. Ну с Dreamweaver-ом вы с вами знакомы из моих видеоуроков по верстке сайта.
Загружаем какой-то HTML-файл в PSPad. И как же нам понять, что за кодировка у загруженного подопытного? Очень просто в строке состояния (внизу) все четко написано.

Кодировка открытого HTML-файла windows-1251

А у этого файла HTML кодировка utf-8
А теперь, создавая новый HTML-документ, позаботимся о его кодировке.
Идем в меню моего любимого PSPad-а. Нас интересует пункт Формат. В нем-то мы и поставим галку напротив кодировки utf-8.

Кодировка будущего HTML-файла будет utf-8

А так кодировка будующего файла — windows-1251
Теперь о том как изменить кодировку файла HTML. Да оказывается очень просто:

Пример перекодирования файла из кодировки windows-1251 в utf-8
Нужно кликнуть по требуемой кодировке в пункте меню Формат и кодировка сменится. После этого сохраняйте файл, он перекодирован, дело сделано.
Что касается Notepad++ все очень похоже на вышеописанную ситуацию. Только для работы с кодировками нужно использовать пункт меню Кодировки.
 Вся разница заключается в том, что в случае Notepad++ появляются, специально разработанные для преобразования кодировок, пункты меню Преобразовать… (лишние на мой взгляд, в PSPad все проще и поэтому я им пользуюсь). Соответственно, именно по ним и нужно кликать при желании поменять кодировки у нашего HTML-файла.
Кроме всего прочего, при сохранении в utf-8 у нас есть выбор: без BOM или с BOM. Нам, как веб-мастерам, нужно использовать кодировку UTF-8 (без BOM).
Вот что нам ответит Википедия на вопрос «что такое BOM»
Если прочитать приведенный текст 10 раз, почесать затылок, то становится понятно: для utf-8 BOM нам НЕ нужен. Кроме того, если сохранить файл с php-скриптом в кодировку utf-8 с BOM, то он не будет работать, потому что обработчик не поймет, что это за ерунда такая написана в начале файла-скрипта (я имею ввиду тот самый неразрывный пробел с нулевой шириной).
Так-так, осталось пристально взглянуть на Dreamweaver.
Создавая новый файл, обращайте внимание на то, в какой кодировке он будет создан. Для этого в окне создания нового документа File → New (Ctrl+N) воспользуйтесь кнопкой Preferences..

И посмотрите, что задано в качестве кодировки по умолчанию:

Кодировка создаваемого HTML-файла по умолчанию в Dreamweaver
Перекодировать открытый HTML-файл в Dreamweaver можно в диалоге Page Properties, который запускается из меню Modify → Page Properties (Ctrl + J).

Выбирайте требуемую кодировку, нажимайте ОК и все, задача по перекодированию выполнена (а вот BOM все так же ненужен, не ставьте галку).
Где указать кодировку сайта
Если проблема возникла на вашем сайте, способ исправления зависит от вида сайта. Для одностраничника достаточно указать кодировку в мета-теге страницы, а для большого сайта есть разные варианты:
- кодировка в мета-теге;
- кодировка в .htaccess;
- кодировка документа;
- кодировка в базе данных MySQL.
Кодировка в мета-теге
Добавьте указание кодировки в head файла шаблона сайта.
При создании документа HTML укажите тег meta в начале в блоке head. Некоторые браузеры могут не распознать указание кодировки, если оно будет ниже.
Мета-тег может выглядеть так:
или так:
В HTML5 они эквивалентны.
Тег кодировки в HTML
В темах WordPress обычно тег «charset» с кодировкой указан по умолчанию, но лучше проверить.
Кодировка в файле httpd.conf
Инструкции для сервера находятся в файле httpd.conf, обычно его можно найти на пути «/usr/local/apache/conf/».
Если вам нужно сменить кодировку Windows-1251 на UTF-8, замените строчку «AddDefaultCharset windows-1251» на «AddDefaultCharset utf-8».
Убедитесь, что сервер не передает HTTP-заголовки с конфликтующими кодировками.
Кодировка в .htaccess
Добавьте кодировку в файл .htaccess:
- Откройте панель управления хостингом.
- Перейдите в корневую папку сайта.
- В файле .htaccess добавьте в самое начало код:
- для указания кодировки UTF-8 — AddDefaultCharset UTF-8;
- для указания кодировки Windows-1251 — AddDefaultCharset WINDOWS-1251.
- Перейдите на сайт и очистите кэш браузера.
Кодировка документа
Готовые файлы HTML важно сохранять в нужной кодировке сайта. Узнать текущую кодировку файла можно через Notepad++: откройте файл и зайдите в «Encoding»
Меняется она там же: чтобы сменить кодировку на UTF-8, выберите «Convert to UTF-8 without BOOM». Нужно выбрать «без BOOM», чтобы не было пустых символов.
Кодировка Базы данных
Выбирайте нужную кодировку сразу при создании базы данных. Распространенный вариант — «UTF-8 general ci».
Где менять кодировку у БД:
- Кликните по названию нужной базы в утилите управления БД phpMyAdmin и откройте ее.
- Кликните на раздел «Операции»:
- Введите нужную кодировку для базы данных MySQL:
- Перейдите на сайт и очистите кэш.
С новой БД проще, но если вы меняете кодировку у существующей базы, то у созданных таблиц и колонок заданы свои кодировки, которые тоже нужно поменять.
Для всех таблиц, колонок, файлов, сервера и вообще всего, что связано с сайтом, должна быть одна кодировка.
Проблема может не решиться, если все дело в кодировке подключения к базе данных. Что делать:
- Подключитесь к серверу с правами mysql root пользователя:mysql -u root -p
- Выберите нужную базу:USE имя_базы;
- Выполните запрос:SET NAMES ‘utf8’;
Если вы хотите указать Windows-1251, то пишите не «utf-8», а «cp1251» — обозначение для кодировки Windows-1251 у MySQL.
Чтобы установить UTF-8 по умолчанию, откройте на сервере my.cnf и добавьте следующее:
Вы когда-нибудь сталкивались с проблемами кодировки на сайте?
4 интерфейса в encoding
Если вы являетесь одним из тех немногих людей, которые заглядывали в пакет encoding, вы можете быть слегка разочарованы. Это второй самый маленький пакет после errors и в нём находятся всего лишь 4 интерфейса.
Первые два — интерфейсы и .
Они предназначены для объектов, которые предоставляют способ конвертировать в и из бинарного формата. Эти интерфейсы используются в нескольких местах в стандартной библиотеке, например в . Вы не найдёте их много где, потому что обычно нет единого способа конвертировать данные в бинарную форму. Как мы уже увидели, есть огромное количество различных форматов сериализации.
Но на уровне приложения, вы скорее всего выберете какой-то один формат для кодирования. Например, вы можете выбрать Protocol Buffers для всех данных. Обычно нет смысла поддерживать сразу несколько бинарных форматов в приложении, поэтому реализация может иметь смысл.
Следующие два интерфейса это и :
Эти два интерфейса очень похожи на предыдущие, но они работают с данными в формате UTF-8.
Некоторые форматы определяют свои собственные интерфейсы для маршалинга, например , и они следуют той же логике имён.
Как определить кодировку на сайте
Определить кодировку страницы своего или чужого сайта можно через исходный код страницы. Откройте страницу сайта, выберите «Просмотр кода страницы» (сочетание горячих клавиш Ctrl+U» в Google Chrome) и найдите упоминание «charset» внутри тега head.
На странице сайта используется кодировка UTF-8:
Указание кодировки в коде страницы
Узнать вид кодирования можно с помощью «Анализа сайта». Сервис проверяет в том числе и техническую сторону ресурса: анализирует серверную информацию, определяет кодировку, проверяет редиректы и другие пункты.
Фрагмент анализа серверной информации сайта
С помощью этого же сервиса можно проверить корректность указанного кодирования. Аудит внутренних страниц «Анализа сайта» проверяет кодировку сервера и сравнивает ее с той, которая указана на внутренней странице. Найденные ошибки Анализ покажет в результатах проверки, и вы сразу узнаете, где нужно исправить.
Отчет о технических данных
Кодировка сервера и страницы
Проверить кодировку еще можно через сервис Validator.w3, о котором писали в статье о проверке валидации кода. Нужная надпись находится внизу страницы.
Кодировка сайта в валидаторе
Если валидатор не обнаружит Charset, он покажет ошибку:
Ошибка указания кодировки
Но валидатор работает не точно: он проверяет только синтаксис разметки, поэтому может не показать ошибку, даже если кодирование указано неправильно.
Библиотека преобразований Unicode-кодировок
В сопутствующий этой статье пакет исходного кода включен пример компилируемого C++-кода. Это повторно используемый код, без ошибок компилируемый в Visual C++ при уровне предупреждений 4 (/W4) в 32- и 64-разрядных сборках. Он реализован как библиотека C++ в виде только заголовочных файлов. По сути, этот модуль преобразования Unicode-кодировок состоит из двух заголовочных файлов: utf8except.h и utf8conv.h. Первый содержит определение C++-класса исключения, используемого для уведомления об ошибке при преобразованиях Unicode-кодировок. Второй реализует собственно функции преобразования Unicode-кодировок.
Заметьте, что utf8except.h содержит только кросс-платформенный C++-код; это делает возможным захват исключения при преобразовании кодировки UTF-8 в любых местах ваших проектов на C++, включая те части кода, которые не специфичны для Windows. Напротив, utf8conv.h содержит C++-код, специфичный для Windows, поскольку он напрямую взаимодействует с границей Win32 API.
Для повторного использования этого кода в ваших проектах просто включайте директивой #include эти заголовочные файлы. Сопутствующий пакет исходного кода содержит дополнительный файл, реализующий некоторые наборы тестов.
ASCII
UTF-8-кодировка полностью поддерживает коды ASCII (0x00-0x7F). Это значит, что символы Юникода U+0000-U+007F конвертируются в единственный байт 0x00-0x7F UTF-8 и таким образом становятся неотличимыми от ASCII. Более того, чтобы избежать многозначности, значения 0x00-0x7F не используются больше ни в одном байте представления символов Юникода. Для кодирования неидеографических символов, отличных от ASCII, используется последовательность из двух байтов. Символы диапазона U+0800-U+FFFF представлены тремя байтами, а дополнительные с кодами больше U+FFFF требуют четырёх байтов.
UTF-8
UTF-8-это код переменной длины. Некоторые символы требуют 1 байт, некоторые требуют 2, Некоторые 3 и некоторые 4. Байты для каждого символа просто записываются один за другим как непрерывный поток байтов.
в то время как некоторые символы UTF-8 могут быть длиной 4 байта, UTF-8 невозможно закодировать 2^32 символа. Это даже не близко. Я попытаюсь объяснить причины этого.
программное обеспечение, которое читает поток UTF-8, просто получает последовательность байтов — как оно должно решить, следующие 4 байта-это один 4-байтовый символ, или два 2-байтовых символа, или четыре 1-байтовых символа (или какая-то другая комбинация)? В основном это делается путем решения, что определенные 1-байтовые последовательности не являются допустимыми символами, а некоторые 2-байтовые последовательности не являются допустимыми символами и т. д. Когда эти недопустимые последовательности появляются, предполагается, что они являются частью больше последовательности.
вы видели совсем другой пример этого, я уверен: это называется побегом. Во многом языки программирования решено, что символ в исходном коде строки не переводится на любой допустимый символ в «скомпилированной» форме строки. Когда \ находится в источнике, предполагается, что он является частью более длинной последовательности, например или
Обратите внимание, что является недопустимой 2-символьной последовательностью и является недопустимой 3-символьной последовательностью, но является допустимой 4-символьной последовательностью
в основном, есть компромисс между наличием многих характеры и иметь более короткие характеры. Если вы хотите 2^32 символов, они должны быть в среднем длиной 4 байта. Если вы хотите, чтобы все ваши символы были 2 байта или меньше, то вы не можете иметь более 2^16 символов. UTF-8 дает разумный компромисс: все ASCII символы (ASCII от 0 до 127) даны 1-байтовые представления, что отлично подходит для совместимости, но разрешено гораздо больше символов.
как и большинство кодировок переменной длины, включая виды побега последовательности, показанные выше, UTF-8 является мгновенная код. Это означает, что декодер просто читает байт за байтом, и как только он достигает последнего байта символа ,он знает, что такое символ (и он знает, что это не начало более длинного символа).
например, символ » A » представлен с использованием байта 65, и нет двух/трех/четырехбайтовых символов, первый байт которых равен 65. Иначе декодер не смог бы сказать. эти символы, кроме «А», за которыми следует что-то еще.
но UTF-8 ограничен еще больше. Это гарантирует, что кодировка более короткого символа никогда не появится в любом месте в кодировке более длинного символа. Например, ни один из байтов в 4-байтовом символе не может быть 65.
поскольку UTF-8 имеет 128 различных 1-байтовых символов (значения которых равны 0-127), все 2, 3 и 4-байтовые символы должны состоять исключительно из байтов в диапазоне 128-256. Это большое ограничение. Однако он позволяет строковым функциям, ориентированным на байты, работать практически без изменений. Например, C функция всегда работает так, как ожидалось, если ее входы являются допустимыми строками UTF-8.
Кодировки на основе Unicode
Unicode можно себе представить как огромную таблицу символов. В памяти компьютера записываются не сами символы, а номера из таблицы. Записывать их можно разными способами. Именно для этого на основе Unicode разработаны несколько кодировок, которые отличаются способом записи номера символа Unicode в виде набора байт. Они называются UTF — Unicode Transformation Format. Есть кодировки постоянной длины, например, UTF-32, в которой номер любого символа из таблицы Unicode занимает ровно 4 байта. Однако наибольшую популярность получила UTF-8 — кодировка с переменным числом байт. Она позволяет кодировать символы так, что наиболее распространённые символы занимают 1-2 байта, и только редко встречающиеся символы могут использовать по 4 байта. Например, все символы таблицы ASCII занимают ровно по одному байту, поэтому текст, написанный на английском языке с использованием кодировки UTF-8, будет занимать столько же места, как и текст, написанный с использованием таблицы символов ASCII.
На сегодняшний день Unicode является основной кодировкой, которую используют в работе все, кто связан с компьютерами и текстами. Unicode позволяет использовать сотни тысяч различных символов и отображать их одинаково на всех устройствах от мобильных телефонов до компьютеров на космических станциях.
Если кодировка не отображается
Если вы зашли на чужой сайт с абракадаброй, а вам все равно очень интересно почитать контент, то в Справке Google объясняют, как исправить кодирование текста через браузер.
О проблеме возникновения абракадабры на вашем сайте будут сигнализировать метрики поведения: вырастут отказы, уменьшится глубина просмотров. Но скорее всего вы и раньше заметите, что что-то пошло не так.
Главное правило — для всех файлов, скриптов, баз данных сайта и сервера должна быть указана одна кодировка. Ошибка может возникнуть, если вы случайно указали на сайте разные виды кодировки.
Яндекс советует использовать одинаковую кодировку для страниц и кириллических адресов структуры. К примеру, если робот встретит ссылку href=»/корзина» на странице с кодировкой UTF-8, он сохранит ее в этом же UTF-8, так что страница должна быть доступна по адресу «/%D0%BA%D0%BE%D1%80%D0%B7%D0%B8%D0%BD%D0%B0».
Утилита Over Drive
Мощное приложение для AMD 64. Программа бесплатная.
Страница загрузки приложения
Сразу же после первого запуска программы всплывает диалоговое окно, которое предупреждает пользователя о том, что он несет полную ответственность за все совершенные в программе действия, которые могут привести к поломке процессора.
После соглашения с предоставленной информацией появится главное окно программы.
Главное окно утилиты OverDrive
Слева найдите пункт, который называется Clock Voltage;
Панель инструментов приложения
- Внимательно изучите появившееся окно. Первая колонка данных – это тактовая частота каждого доступного ядра микропроцессора. Вторая вкладка — порядковый множитель ядра, это число и нужно изменить;
- Чтобы настроить множитель, необходимо нажать на кнопку Контроль скорости. Она выделена зеленым цветом на рисунке ниже. Затем отрегулируйте ползунки.
Порядок действий для разгона микропроцессора с помощью программы OverDrive
[править] BOM (сигнатура)
Многие программы Windows (включая Блокнот) добавляют байты 0xEF, 0xBB, 0xBF в начале любого документа, сохраняемого как UTF-8.
Это метка порядка байтов (англ. Byte Order Mark, BOM), также её часто называют сигнатурой (соответственно, UTF-8 и UTF-8 with Signature). По наличию сигнатуры программы могут автоматически определить, является ли файл закодированным в UTF-8, однако файлы с такой сигнатурой могут некорректно обрабатываться старыми программами, в частности xml-анализаторами. Такие редакторы, как Notepad++, Notepad2 и Kate, позволяют явно указывать, следует ли добавлять сигнатуру при сохранении UTF-файлов.
Например: В файле записана одна латинская буква «a».
- Если кодировка этого файла UTF-8 with Signature, то он будет содержать: 0xEF 0xBB 0xBF 0x61
- Если кодировка этого файла UTF-8 (без сигнатуры), то он будет содержать: 0x61
Если считывающая программа не поддерживает BOM, то эти три байта успешно раскодируются в один Unicode-символ 0xFEFF. Это не разрывающий слова пробел нулевой ширины и поэтому он может не отобразиться. Этот же символ используется в BOM для кодировок UTF-16 и UTF-32.